产品介绍
这个项目到底是什么、靠什么赚钱

Levels.fyi:3M 月活却从不卖数据的薪酬数据库
网站是什么
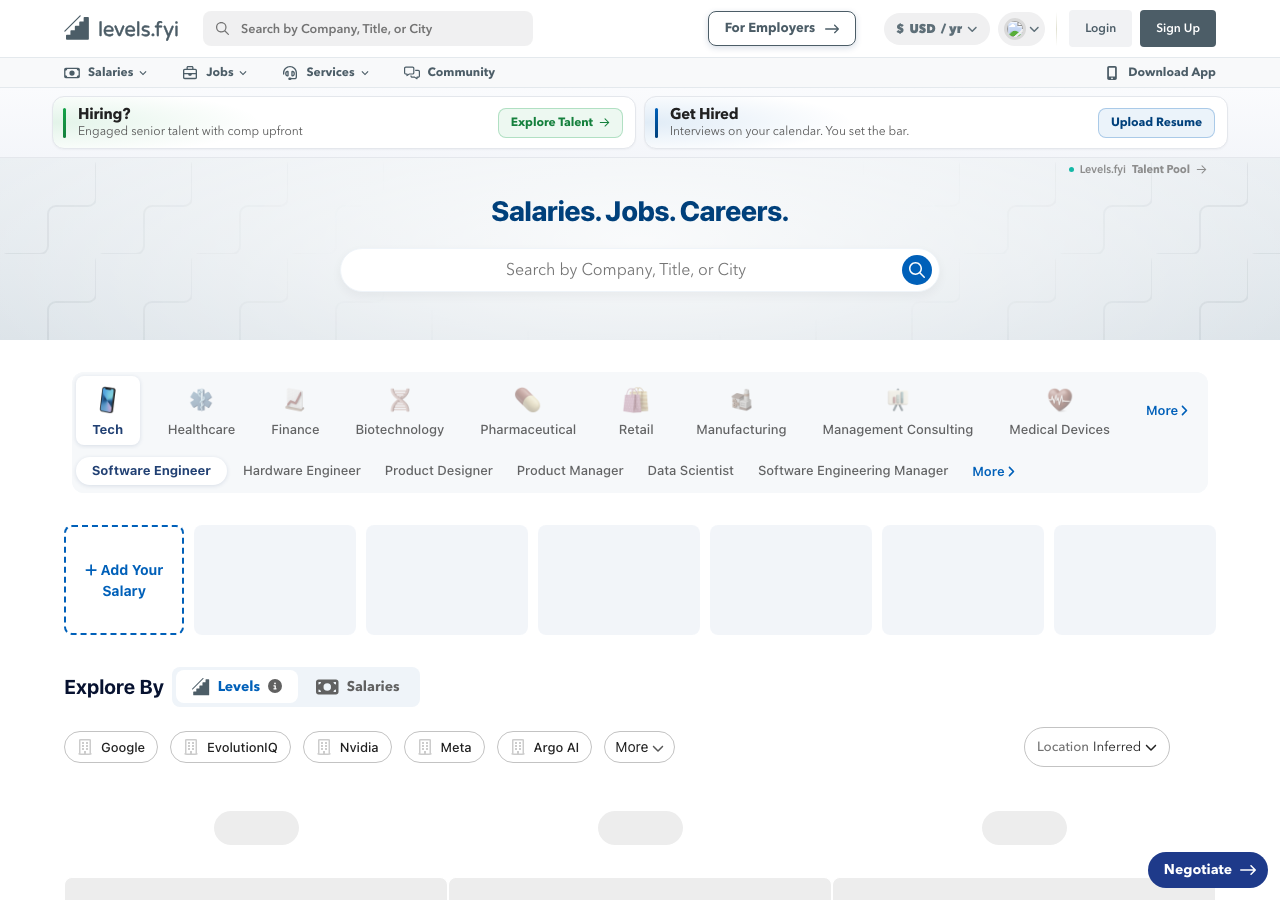
Levels.fyi 是一个科技行业的薪酬与职级数据库。
它记录了 FAANG、Stripe、OpenAI 等公司从 L3 到 L8 的总包(base + stock + bonus)、offer 对比、各 level 之间的对应关系。你在入职前想知道”自己会不会被降级”、跳槽时想知道”这家给的 E5 是不是低于市场”,都来这个站。
整个网站的核心数据对所有人免费。
用户怎么贡献数据
Levels.fyi 的冷启动走的是 匿名提交 + 交叉校验:
- 匿名提交:用户在站内上传自己的 offer、level、年限、地区,承诺一定匿名性。
- 交叉校验:平台会对提交做交叉验证——多个人提交同一公司同一 level 的数据会进入统计,异常数据会被剔除。
- 数据真实:因为是匿名,所以愿意贡献真实数字的人多;因为有交叉校验,所以个人 PII 数据不会被滥用。
怎么赚的钱
Levels.fyi 故意把”核心数据本身”做成永久免费——它在 About 页面明确写永不收钱修改或隐藏薪酬数据。
赚钱的是两件事:
C 端(求职者付费)
- 简历修改服务
- 薪酬谈判辅导(mock interview / 模拟谈判)
- 求职信的 review
B 端(雇主付费)
- Compensation Benchmarking(薪酬基准报告,给 HR 团队用)
- Interactive Offers(offer 对比工具的付费版)
- 雇主品牌 / 职位曝光
数据免费层负责拉 300 万月活流量,付费层吃”求职焦虑 + 招聘竞争”的红利——两端不冲突。
增长方式
Levels.fyi 没有传统意义上的”运营”,它的增长完全是自然增长:
- Google SEO:每一份 offer 数据都生成独立可搜索页面(“Stripe E5 total compensation”、“FAANG L4 base”),长尾词全占住。
- 口碑传播:薪资是同事间必聊的话题,求职者看完会主动转发。
- 媒体引用:WSJ、TechCrunch、Bloomberg 报道薪酬时首选数据源,反向带来大量新用户。
官方 about 页明确写:每月 300 万专业人士使用。
创始人是谁
Zuhayeer Musa 和 Zaheer Mohiuddin 两位前 AWS 工程师,2017 年作为副业起步(about 原文:“Levels.fyi started in 2017 as a side project”)。
注意:是 2 人联合创始人,不是 solo。这个项目靠两个人就把”全美科技公司薪酬数据”做成了事实标准,本身就说明了切口选得多准——这不是大公司做出来的东西,是工程师自己痛过、决定自己解决。
这个案例能学到什么
第一,切”人人都想看、没人敢公开”的数据集。工资是职场最大暗箱,Levels.fyi 把它变明盒。匿名 + 校验是关键。
第二,把”免费层”和”赚钱层”拆开。核心数据免费(拉流量),服务和雇主(赚钱)。两边互相不矛盾——反而互相加固。
第三,切入点要一句话说清。不是”做招聘站”,而是”让你入职前就知道自己会不会被降级”。一个点打透,比铺功能重要得多。
第四,公开承诺让信任资产可累积。“永不收钱改数据”这一句话,直接决定它能不能在用户心里活过初创期。
来源与数据
- 站点:https://www.levels.fyi
- 商业模式:https://www.levels.fyi/about/(“3 million professionals”、“never charges to modify compensation data”)
- B 端变现页:https://www.levels.fyi/offerings/data/
- 收入:官方未披露(站长从未公开营收数字)
一句话总结
两个人把全美科技公司的薪酬变明盒,核心数据永久免费,靠”焦虑服务”和”雇主报告”赚钱。
给别人的启发
别人做对了什么,你能直接抄的部分
切"人人都想看、没人敢公开"的数据集,用匿名 UGC + 交叉校验冷启动
免费数据层只负责拉流量,收费层放在"服务"和"雇主侧",核心数据本身绝不收钱
切入点要极窄到一句话说清
第三方估算:第三方工具推算,只给区间不给精确数
其他信息
同类案例