产品介绍
这个项目到底是什么、靠什么赚钱
Fish Audio:卧室里一张显卡训出来的模型,一年做到 ¥1.41亿收入
产品是什么
Fish Audio 是一家做 AI 语音生成的公司。
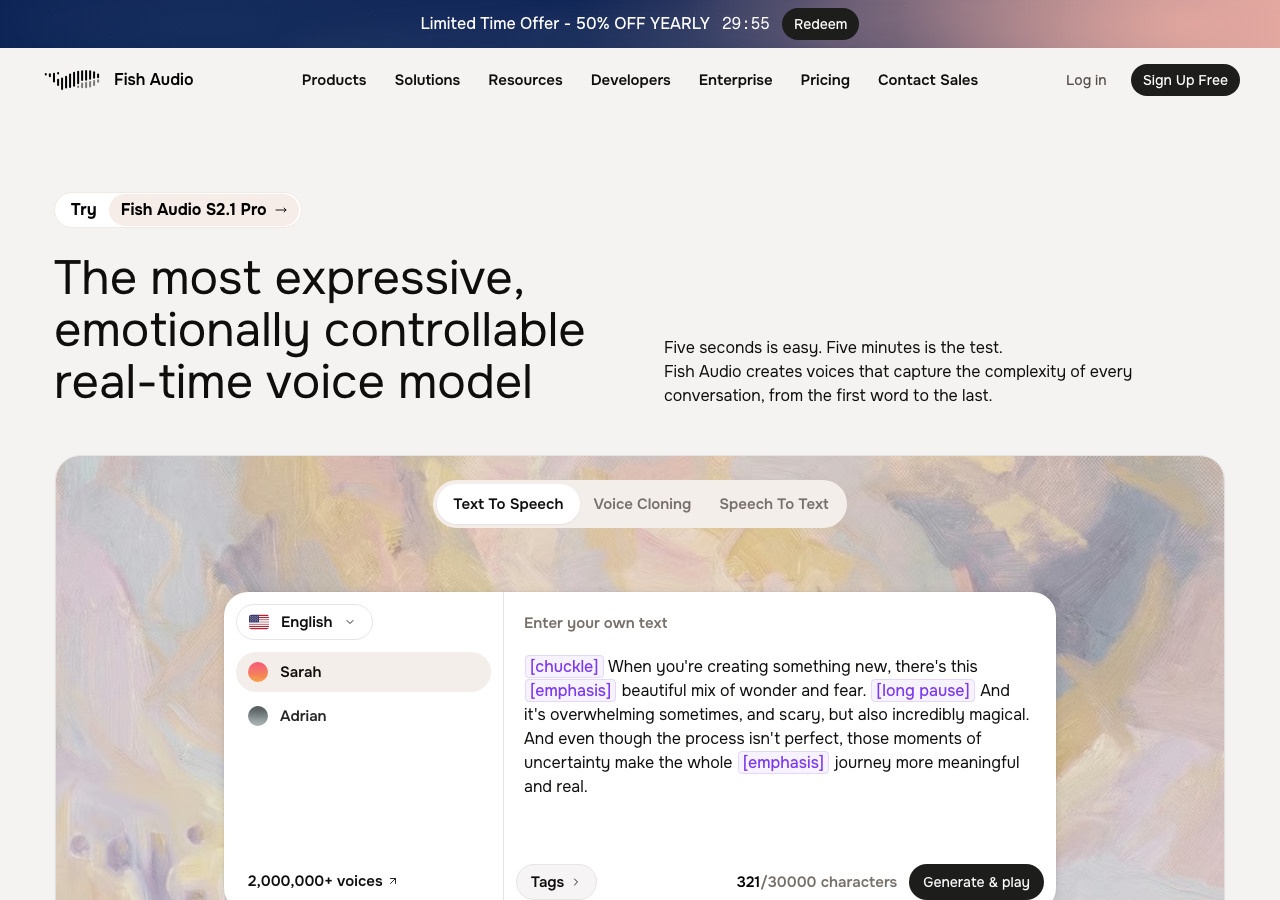
它能做的事:从一段很短的音频里克隆一个声音,几秒钟完成;支持 83 种以上语言;提供文本转语音、语音识别、语音克隆和长音频工具。
真正让它在开发者圈里出圈的,是这套东西的可控性:
- 15000 多项自然语言控制。你可以直接用自然语言描述「语速快一点、带点犹豫、情绪上扬」,而不是调一堆抽象参数。
- 用户提交的声音库超过 200 万个。
- 旗舰模型 S2.1 Pro 只通过付费 API 提供;其余几个语音生成模型开源。
- 盲测中约三分之二的听众更偏好它的输出而非竞品。
它的根是一个开源项目:Fish Speech,在 GitHub 上有 3.1 万多个 star。
怎么赚的钱
开源引流,托管 API 与企业授权变现。
- 个人与团队:按月购买生成时长,解锁声音克隆等能力
- 企业客户:专属 API、私有化部署、服务水平保障、HIPAA 合规与零数据留存
关键数字:
- ¥1.41亿 ARR(2026 年 7 月)
- 800 万以上用户
- 融资 ¥3.49亿,全部是一轮种子轮,2026 年 7 月 28 日宣布
一家还在把融资叫「种子轮」的公司已经有 ¥1.41亿 ARR,这件事本身就说明了它的商业化速度。
流量从哪来
第一,开源就是分发渠道。Fish Speech 开源之后,独立开发者、独立游戏工作室、内容创作者开始自发使用并在社区传播。3.1 万个 GitHub star 不是虚荣指标,是真实的安装量与口碑。
第二,被其他公司的产品带进去。HeyGen 用它做 AI 数字人的语音,LiveKit 与 Retell AI 用它做语音 Agent 的实时对话。这些集成本身带来了企业侧的曝光。
第三,成本结构本身就是卖点。他们重写了推理栈并自研 FP8 GPU 算子库,让免费档位也能负担得起,同时给付费客户留出利润空间。
第四,创始人故事自带传播性。前 NVIDIA 研究员在卧室里用一张游戏显卡,因为受不了合成语音「没有情绪」而自己训了一个模型——这个故事在开发者社区几乎不需要花钱就能传开。
站长是谁
Shijia Liao,联合创始人兼首席科学家,曾是 NVIDIA 的视频研究员。
他对现有合成语音的不满非常具体:太平了,没有情绪表达。于是他在自己的卧室里,用一张游戏显卡训练了早期的语音生成模型,然后直接开源。这就是 Fish Speech 的起点。
Rissa Cao,联合创始人兼 CEO,负责把这件事从开源项目变成一门生意。她的公开规划包括:为医疗、金融等受监管行业做私有化部署和零数据留存方案。
这个案例能学到什么
第一,开源和赚钱不是二选一,可以是同一件事的两半。开源负责分发,托管 API 负责变现。绝大多数用开源模型的人不会自己部署和运维,这正是付费服务的空间。
第二,起点可以只是「不满」。他没有做市场调研,只是受不了现有的合成语音没有情绪,然后自己动手训了一个。最好的产品动机往往来自创始人的真实痛点,不是来自一份分析报告。
第三,在巨头环伺的赛道里,换一个维度切进去。语音合成领域有 ElevenLabs 这样的头部玩家。Fish Audio 不比「谁的声音更像真人」,它比的是开发者可控性——15000 项自然语言控制、开源、便宜、能私有化部署。这是一群完全不同的买家。
第四,把合规做成产品能力,而不是应付法务。声音克隆的版权争议是真实存在的:有过英国配音演员的声音被他人上传并出售、被下载 900 多次的报道。Fish Audio 的应对是把下架流程做到3 分钟内完成。在企业采购里,这件事的权重正在快速上升。
第五,创作者工具是企业生意的入口,不是终点。他们从创作者做起,做到 800 万用户后才往企业走。这时候合规部署能力(HIPAA、零数据留存、私有化)就成了门票——没有它,根本进不了医疗和金融的采购名单。
来源与数据
- 站点:https://fish.audio
- 融资:¥3.49亿种子轮,2026 年 7 月 28 日宣布,Coreline Ventures 与 Capital Today 共同领投,359 Capital、Parable、Play Time、Alphalist Partners、Bayhouse Ventures、Carya Venture Partners、HF0 参投(TechCrunch、SiliconANGLE、Yahoo Finance)
- 营收与用户:超 800 万用户、¥1.41亿 ARR,数据截至 2026 年 7 月,距商业化上线约一年(TechCrunch、TMC Insight、Fundraise Insider)
- 开源:Fish Speech 仓库 GitHub 3.1 万+ star(TechCrunch、TMC Insight)
- 产品:文本转语音、语音识别、语音克隆、长音频工具;支持 83+ 语言;15000+ 项自然语言情绪与节奏控制;用户提交声音库超 200 万个;旗舰模型 S2.1 Pro 仅限付费 API;盲测中约三分之二听众更偏好其输出(TechCrunch、Brief News)
- 客户:HeyGen、Sanas、Plaud、LiveKit、Retell AI(TechCrunch、TMC Insight)
- 合规:提供 HIPAA 合规的私有化部署与零数据留存方案;存在声音版权争议,公司提供 DMCA 下架流程并称可在 3 分钟内完成移除(TechCrunch、TMC Insight、BBC 相关报道)
- 创始人:Shijia Liao 前 NVIDIA 视频研究员,在卧室用单张游戏 GPU 训练早期模型并开源;Rissa Cao 任 CEO(Fundraise Insider、TechCrunch)
一句话总结
一个前 NVIDIA 的视频研究员,受不了合成语音「太平了没有情绪」,在自己卧室里用一张游戏显卡训了个模型,直接开源——这就是 Fish Speech,后来拿到 3.1 万个 GitHub star。公司做起来的路径很清晰:开源负责分发,托管 API 负责变现。一年时间,800 万用户、¥1.41亿 ARR,然后拿了 ¥3.49亿种子轮。它没跟 ElevenLabs 比谁的声音更像真人,它比的是开发者可控性——15000 项自然语言控制、能私有化部署、便宜。连声音版权争议都被他们做成了产品能力:下架流程压到 3 分钟。真正可迁移的那句话是:开源和赚钱不是二选一,绝大多数用开源模型的人不会自己部署运维,那正是你的付费空间。
给别人的启发
别人做对了什么,你能直接抄的部分
开源是最便宜的分发,付费 API 是最直接的变现,两者可以是一件事的两半
起点可以只是不满——他只是受不了合成语音没有情绪,于是在卧室用一张显卡自己训
在巨头环伺的赛道里,用「开发者可控性」和成本效率切进去,而不是比谁的声音更像真人
声音版权争议会变成采购标准,提前把下架流程做到分钟级就是在建护城河
从创作者工具往企业走时,合规部署(HIPAA、零数据留存)是门票不是加分项
官方披露:公司/创始人自己公布的数字
其他信息
同类案例